Mi változott húsz év alatt?
Kétezres évek eleje: aki egy 19. századi vidéki lap cikkére volt kíváncsi, annak fel kellett utaznia Budapestre, kikérni a kötetet, végiglapozni, és reménykedni, hogy a keresett szám nem hiányzik. Egy kutatási kérdés megválaszolása hetekbe telt, és sok kérdést fel sem tettek, mert a feldolgozási idő aránytalan lett volna.
Ma ugyanez a művelet néhány perc: a digitalizált, kereshető szövegű állományban egyetlen kifejezésre rá lehet keresni, és azonnal látszik, hány találat van, milyen években, mely lapokban. Ez nem gyorsítás, hanem minőségi különbség – olyan összefüggések válnak láthatóvá, amelyeket kézi lapozással soha nem lehetett volna kimutatni.
A legjobb példa a szóhasználat-történet. Ha valaki azt akarja tudni, mikor jelenik meg először egy fogalom a magyar sajtóban, és milyen ütemben terjed, azt ma egy keresés és néhány szűrő megválaszolja. Húsz éve ez önálló doktori kutatás lett volna.
A legfontosabb magyar felületek
A Hungaricana a magyar közgyűjteményi portál: levéltári, könyvtári és múzeumi anyagokat gyűjt egybe. Itt érhető el többek között térképek, fényképek, plakátok, helytörténeti gyűjtemények és levéltári iratok jelentős tömege – nagy részük ingyenesen.
Az Arcanum Digitheca a folyóirat- és könyvdigitalizálás legnagyobb hazai vállalkozása: a magyar sajtótörténet gerincét adó lapok évfolyamai, lexikonok, kézikönyvek kereshető formában. A szolgáltatás előfizetéses, de sok könyvtár biztosít hozzáférést az olvasóinak – ez a gyakorlatban azt jelenti, hogy egy könyvtári tagsággal az anyag nagy része elérhető.
Ezek mellett működik az Országos Széchényi Könyvtár digitális könyvtára, a megyei könyvtárak helyismereti adatbázisai és számos múzeumi online gyűjtemény. Európai szinten az Europeana fogja össze a tagállami közgyűjtemények digitális anyagát.
Mit jelent a „kereshető szöveg"?
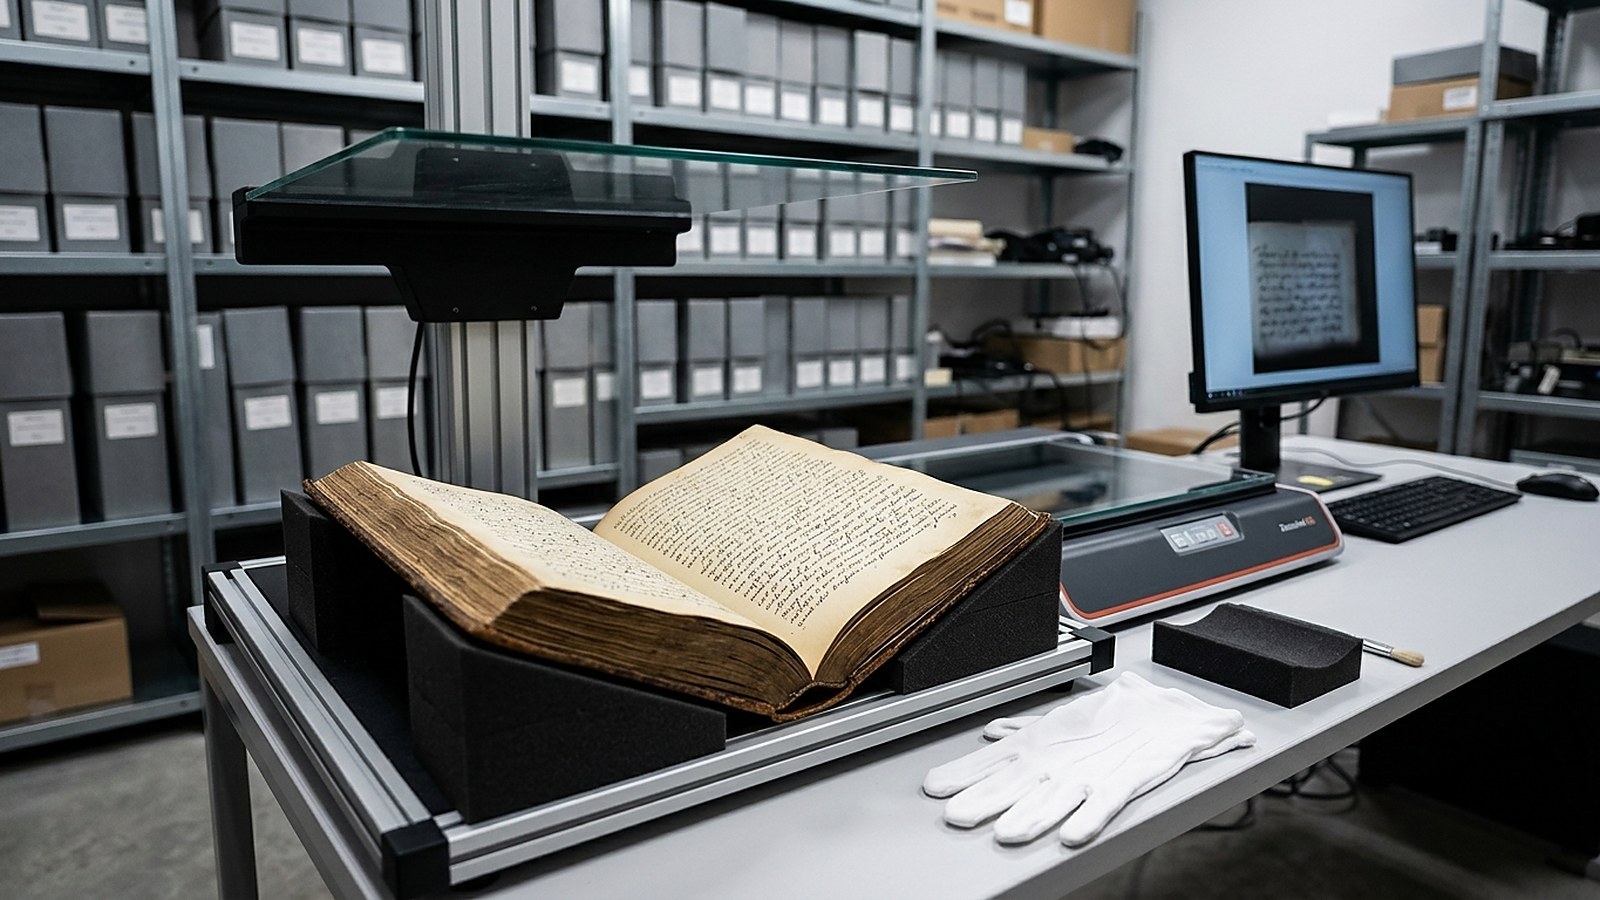
A digitalizálásnak két szintje van. Az első a képi digitalizálás: az oldalról fénykép készül. Ez már önmagában óriási előrelépés – nem kell utazni, nem kopik az eredeti –, de a keresés szempontjából nem sokat ér, mert a gép nem tudja, mi van a képen.
A második szint az optikai karakterfelismerés (OCR): a szoftver a képből szöveget állít elő. Innentől kereshetővé válik az anyag. A magyar nyelv esetében ez technikailag nehezebb feladat, mint az angolnál: a hosszú magánhangzók, a régies helyesírás, a gót betűs vagy kézírásos anyag mind rontja a felismerés pontosságát.
Ezért fontos tudni, hogy a keresés soha nem száz százalékos. Ha valaki egy kifejezésre nem talál semmit, az nem feltétlenül azt jelenti, hogy nincs – lehet, hogy az OCR félreolvasta. A jó kutatói gyakorlat ezért többféle írásmóddal is próbálkozik.
Amit a digitalizálás nem old meg
Három korlát rendszeresen visszatér. Az első a szelekció: nem minden van digitalizálva, és ami igen, az nem véletlenszerű minta. A nagy, országos lapok szinte teljesen elérhetők, a kisebb vidéki kiadványok gyakran hiányoznak – ez pedig önmagában torzítja a kutatási eredményeket.
A második a jogi helyzet. A szerzői jogi védelem alatt álló, 20. századi anyag nagy része nem tehető szabadon hozzáférhetővé, ezért a digitalizált állomány súlypontja a régebbi korszakokra esik. Az 1950 utáni évtizedek kutatása ma is nehezebb, mint a 19. századé.
A harmadik a fenntarthatóság. A digitális állomány nem örök: szervert, mentést, formátumkonverziót és folyamatos szakmai gondozást igényel. Egy digitalizált gyűjtemény, amelyet öt évig nem tart karban senki, ugyanúgy elveszhet, mint egy beázott raktár tartalma.
Kinek hasznos ez a hétköznapokban?
Nemcsak kutatóknak. A családfakutatás az elmúlt évtized egyik legnagyobb amatőr tudományos mozgalma lett, és szinte teljes egészében a digitalizált anyakönyvekre és levéltári forrásokra épül. Ma egy átlagos érdeklődő néhány hét alatt eljuthat a 18. századig visszamenő családi adatokig.
Hasonlóan hasznos a helytörténet: egy település régi képeslapjai, sajtóhírei, térképei ma jellemzően online elérhetők. Ezek az anyagok a helyi közösségi identitás fontos forrásai lettek – iskolai projektekben, kiállításokon, helyi kiadványokban.
A közgyűjteményi hozzáférés kérdése egyébként szorosan összefügg azzal is, hogyan alakul a hazai könyv- és médiapiac digitális átállása – erről a digitális tartalmakról szóló írásunkban is szó esett.
Mi jön ezután?
A következő nagy lépés a kézírás felismerése. A levéltári anyag túlnyomó része kézzel írott, amit a hagyományos OCR nem tud kezelni. Az utóbbi évek gépi tanulásra épülő rendszerei viszont már kezelhető pontossággal olvasnak régi kézírást is – ha ez elterjed, a levéltári kutatás ugyanolyan fordulaton megy át, mint húsz éve a sajtóanyag.
A második irány az összekapcsolás: a különböző gyűjtemények adatainak összefűzése, hogy egy név, egy hely vagy egy esemény minden előfordulása egyszerre legyen látható. Ez technikailag nehéz, de a valódi kutatási ugrás itt van.
GYIK – digitális közgyűjtemények
Mi a Hungaricana?
Magyar közgyűjteményi portál, amely levéltári, könyvtári és múzeumi anyagokat – térképeket, fényképeket, iratokat, helytörténeti gyűjteményeket – tesz elérhetővé.
Mi az Arcanum Digitheca?
A legnagyobb hazai folyóirat- és könyvdigitalizálási vállalkozás; előfizetéses, de sok könyvtár biztosít hozzáférést az olvasóinak.
Mit jelent az OCR?
Optikai karakterfelismerés: a beszkennelt oldalképből kereshető szöveget állít elő.
Miért nem talál meg a kereső mindent?
Mert az OCR pontossága nem száz százalékos – a régies helyesírás, a rossz nyomatminőség és a kézírás egyaránt rontja.
Miért hiányzik a 20. század nagy része?
Elsősorban szerzői jogi okokból: a védelem alatt álló anyag nem tehető szabadon hozzáférhetővé.
Alkalmas-e ez családfakutatásra?
Igen, a digitalizált anyakönyvek és levéltári források ma a családfakutatás legfontosabb forrásai.
Mi a következő nagy fejlesztés?
A kézírás gépi felismerése, amely a levéltári anyag túlnyomó részét tenné kereshetővé.